※この記事はH0: Hack the Zero Stack with Vercel v0 and AWS Databasesというハッカソンへの参加を目的として執筆しました。#H0Hackathon
H0ハッカソンとは
H0(Hack the Zero Stack)は、AWSとVercelが共同開催しているハッカソンです。特定の技術スタックの組み合わせに焦点を当てているのが特徴で、v0(VercelのAI UIジェネレーター)で素早く作ったNext.jsフロントエンドを、Amazon Aurora PostgreSQL、Aurora DSQL、Amazon DynamoDBのいずれかのAWSデータベースに接続する、という構成が条件になっています。
コンセプトはシンプルです。多くの週末ハッカソンのプロトタイプは実際のトラフィックに耐えられず、一方で本番運用クラスのデータ基盤は構築に時間がかかりすぎてハッカソンには向きません。H0はそのトレードオフを取り払い、v0で数分で作れるフロントエンドと、すでに本番スケールで実績のあるデータベースを組み合わせられるようにしています。締め切りは2026年6月29日で、4つのトラック(B2C、B2B、大規模グローバルアプリ、オープンイノベーション)に対して合計8万ドルの賞金、さらに8万ドル分のAWSクレジットが用意されています。
私はTrack 4: Open Innovationで参加しました。
このアプリを作ろうと思ったきっかけ
このアイデアはハッカソンから始まったわけではありません。きっかけはアメリカへの出張でした。
シアトルで開催されるカンファレンスに参加することになり、英語の講演をリアルタイムで聞き取れるほどのリスニング力が自分にはないことは分かっていたため、手軽に利用できるツールを探しました。リアルタイムで講演を翻訳し、できれば後から内容を振り返れる要約機能があればベストでした。
しかし短期でオンデマンドで利用できるツールは見つからず、リアルタイム翻訳やアーカイブができるツールの多くはサブスクリプション契約が必須で、短い期間での利用には不向きに感じました。無料の選択肢も悪くはなかったのですが、特定のユースケース向きのものが多く、特にスマホアプリは数分以上のセッションになると電池消耗やアプリの切り替えによる中断が発生し、後から見返せる永続的なアーカイブもありません。今回私が機能として欲しているリアルタイム翻訳と、事後に検索できる要約を兼ね備えたものは見つかりませんでした。
本当に欲しかったのはシンプルなものでした。出張のためだけにすぐ立ち上げられて、使った分だけ払い、帰国したらもう考えなくていいもの。そのギャップを埋めるために作ったのがHonraku Taroです。
ちなみにHonraku Taro(翻楽太郎)の語源は日本語の「翻訳」と「楽」を併せて、日本人のなじみのある名前である「太郎」を結合したものです。
※私が笑点で好きだった三遊亭楽太郎(6代目三遊亭円楽)師匠の名前からも拝借しております。
AWSのアーキテクチャと実装の話
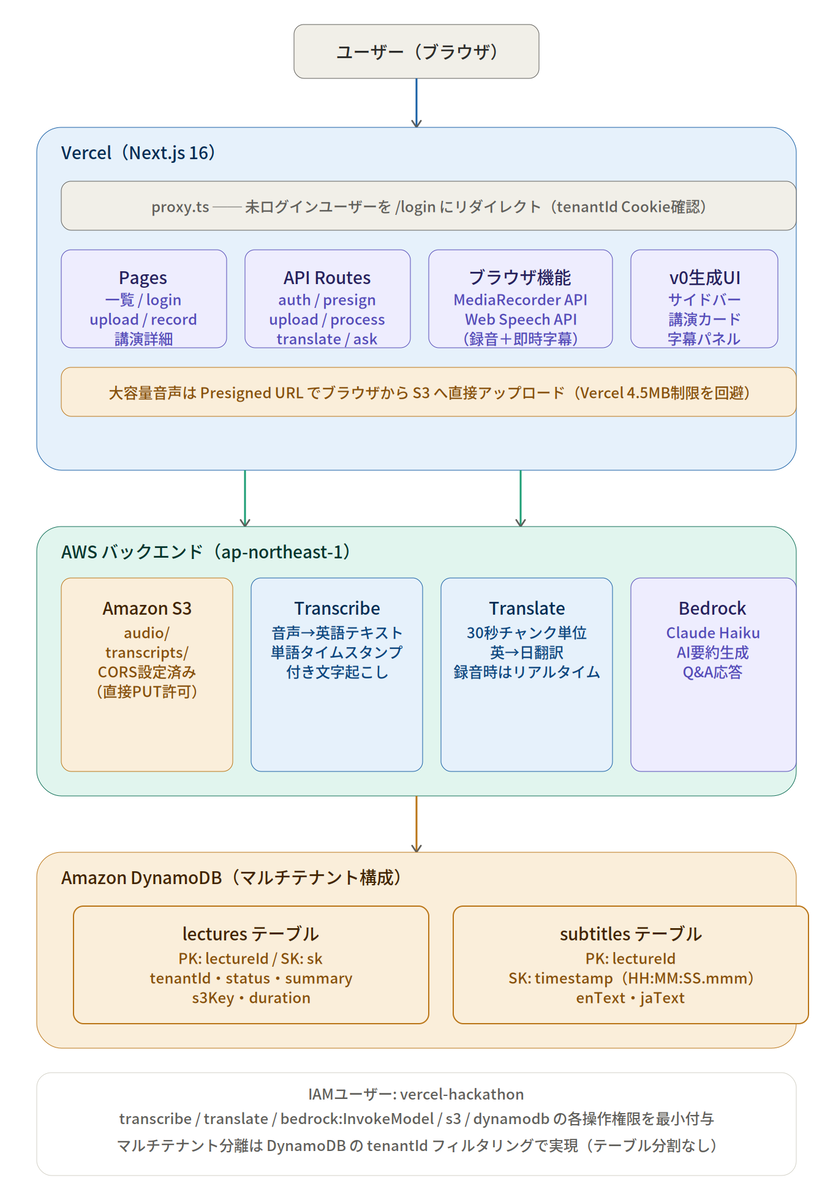
Honraku TaroはVercelにデプロイしたフルスタックのNext.jsアプリで、データとAIの処理はAWSが担っています。全体像は以下の通りです。
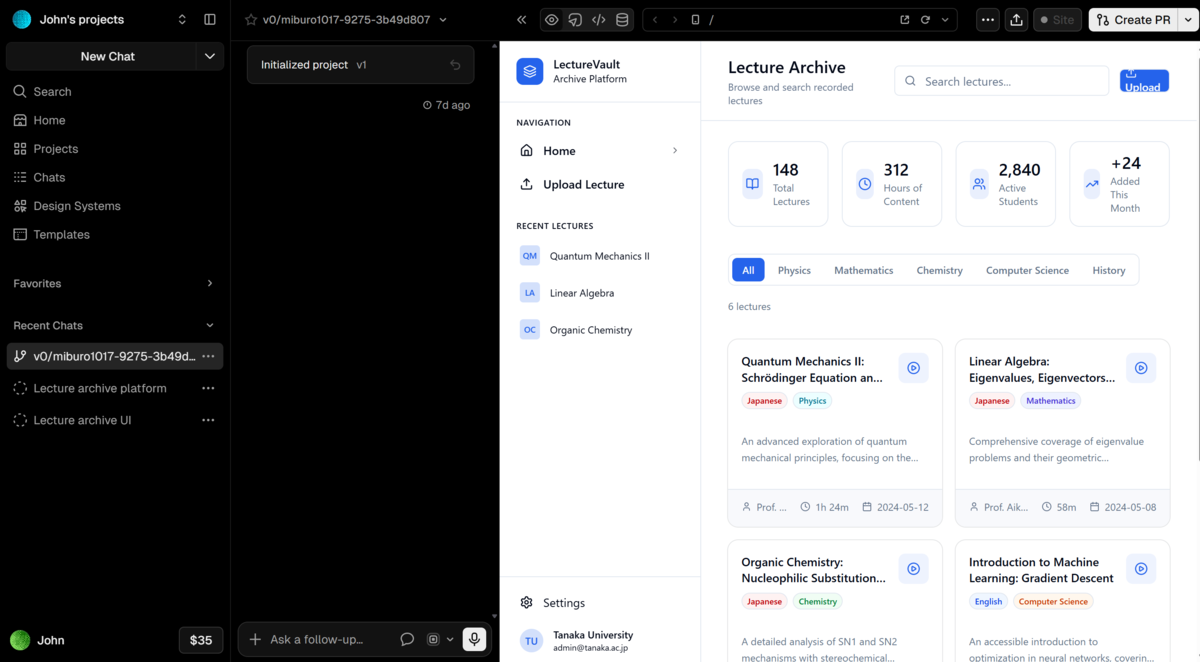
また今回の肝であるv0の活用ですが、v0チャット欄に以下を入力してベースのデザインを作成しています。
Build a lecture archive platform UI with Next.js and Tailwind CSS.

Pages needed:
1. Home page - lecture list with cards showing title, speaker, date, duration, language badge
2. Upload page - drag and drop audio file upload with title/speaker/date input fields
3. Lecture detail page - audio player with synchronized Japanese subtitles panel on the right, AI summary section below, and a Q&A chat interface at the bottom

Design: Clean, professional, dark sidebar navigation. Use a blue and white color scheme.
AWSのアーキテクチャを含めた機能面の設計は以下の思想で行っております。
DynamoDB選定の理由
このアプリのアクセスパターンは狭く予測可能です。ある講演について、タイムスタンプ順にすべての字幕を取得すること、あるいは講演メタデータをIDで引くこと、これだけです。エンティティ間のJOINは不要で、すべての読み取りは単一パーティション内のソートキー順フェッチで済みます。これはまさにDynamoDBが得意とする形です。subtitlesテーブルはlectureIdをパーティションキー、timestampをソートキーにしているため、ある講演の字幕全体を取得するのは1回のQueryで済み、結果は時系列順であるため、クライアント側でのソートも不要です。Auroraベースのリレーショナルスキーマでは、実際には必要のないSQLの柔軟性を得る代わりに、プロビジョニングや接続管理のコストを払うことになります。これはサーバーレスでバースト的なワークロード(利用の大半はライブ講演前後の短時間スパイクで、定常的なトラフィックではない)には不向きだと判断しました。なお、現時点でキャパシティを事前に確保するほどの処理量はないという点も踏まえて、オンデマンドの方がこのプロジェクトのコンセプト(出張のような不定期・短期的な利用に対して使った分だけ支払う)とも合致しています。仮にこのアプリを本格的に公開する場合でも、適切なプロビジョンドキャパシティのスペックを選ぶには実際のメトリクスを見て当たりをつける必要があり、その判断ができる段階に至るまではオンデマンドの方がコストメリットが高いと考えています。
presigned URLの活用
Vercelのサーバーレス関数にはリクエストボディ4.5MBの上限があり、数分以上の音声ファイルはこれを簡単に超えてしまいます。ブラウザがpresigned URLを使ってS3に直接PUTする方式にすることで、この制限を完全に回避しています。Vercel側はファイルのバイト列に一切触れません。
字幕のチャンキングについて
小さいチャンクで翻訳するほど字幕の粒度が細かく正確なタイムスタンプになりますが、講演全体に対してそれを行うと、処理関数が完了前にタイムアウトするリスクが高まります。30秒という間隔とmaxDurationの延長を組み合わせることで、タイムスタンプの精度と処理の安定性の両方を妥協できる範囲に収めました。
Bedrockの活用
Transcribeはテキストの文字起こし、Translateは多言語への翻訳を行いますが、文字起こし・翻訳しただけのテキストはそのままでは読みづらく、内容を把握するには時間がかかります。これに対し、Amazon Bedrockの基盤モデルを活用し、全文を推論・要約を行うことで、構造化された出力(概要・重要ポイント・キーワード)を生成することができます。また、全文から自分の知りたい情報だけ検索できるようにAIチャット欄も利用できるようにしております。なお、この処理で行う基盤モデルはClaude Haiku 4.5を利用しており、このアプリの一つのコンセプトである「低価格で利用できる」という点の一助になっております。
AWSとの連携について
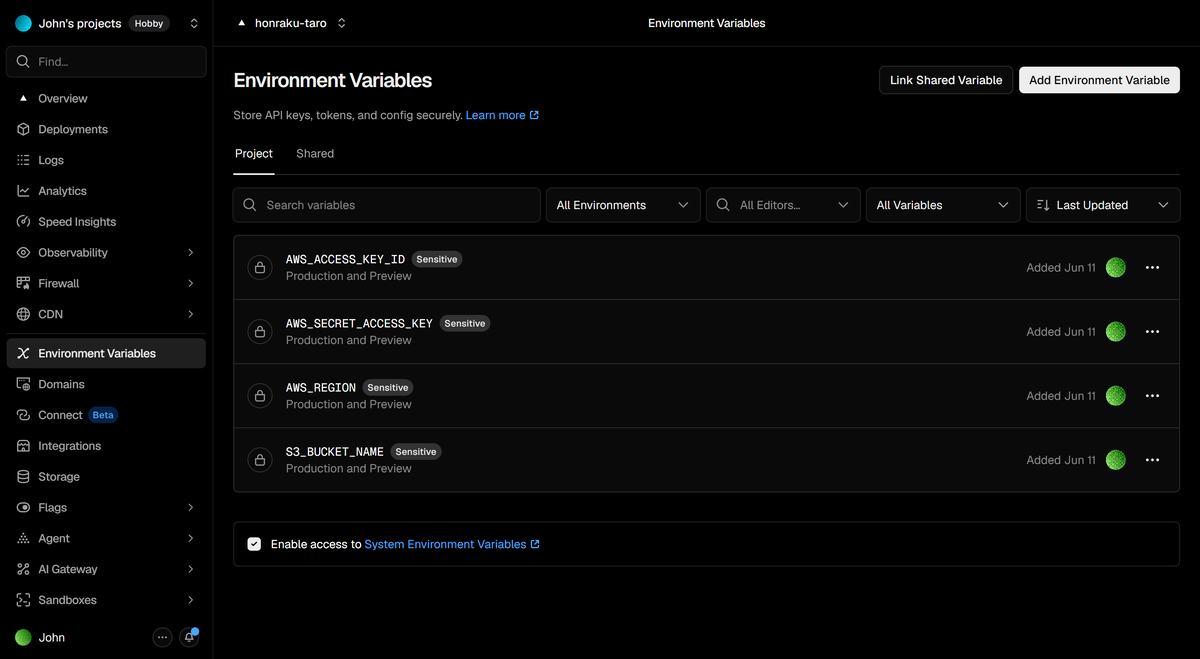
今回開発したアプリケーションはVercel側からAWSを呼び出すために専用のIAMユーザー(vercel-hackathon)を作成し、付与する権限は最小権限の原則に則りこのアプリが実際に呼び出すAPIアクションだけに絞っています。言うまでもありませんがアクセスキーはコードに直接埋め込まず、Vercelコンソール上の「Environment Variables」に保管しております。
完成したアプリケーションの紹介
実際の使い方は意図的にシンプルにしています。
組織コードでサインイン
アカウント作成は不要(少なくとも現状は)。最初からマルチテナント構成で、DynamoDBの読み取りはすべてtenantIdで絞り込まれます。ライブモード
講演中に録音を開始すると、話されている英語にほぼリアルタイムで日本語字幕が表示されます。アップロードモード
長めの録音をアップロードすると、文字起こし・翻訳・要約までのパイプラインが自動で走ります。アーカイブ
処理済みの講演はすべてタイムスタンプ付き字幕・AI要約とともに保存され、Q&Aボックスで「Xについて何と言っていた?」と聞けるので、文字起こし全体をスクロールする必要がありません。
サブスクリプションなし、シート課金なしで、実際に使った分だけAWSに支払う形です。一度の出張のためにスポットで利用したい人にとっては非常に扱いやすいサービスになっており、シンプルかつ低コストであることがサービスの重要なポイントです。
動作デモ動画
サインインからライブ翻訳、長めの講演のアップロード、処理パイプライン、AI要約、Q&A機能、そしてアーキテクチャの解説まで、一通りの操作を録画しましたので、もしよかったらご覧ください!
今後の展望
いくつか拡張したい方向性があります。
品質の向上(最優先)
まず優先度が高いのはリアルタイム翻訳の品質向上です。現状はブラウザのWeb Speech APIによる英語認識結果をそのままAmazon Translateに渡していますが、認識精度や訳文の自然さにはまだ改善の余地があり、専門用語や話者の発話スピードによってずれが生じることがあります。文脈を踏まえた訳文生成や、認識結果の事後補正なども検討したいところです。マルチユーザー対応
現状このアプリケーションのコアな部分ではないため機能から除外していますが、後々は特定または不特定のユーザーにそれぞれのワークスペースの提供を行いたいと思っております。その他
フルのアップロードフローを経由しない軽量な「クイックセッション」モード、複数講演者のパネルディスカッションに対応する話者分離機能などを考えています。可能な限り現状のオンデマンドな課金形態は維持し、コンセプトは曲げないような工夫は続けたいと考えています。
この記事はH0: Hack the Zero Stack with Vercel v0 and AWS Databasesへの参加を目的として執筆しました。#H0Hackathon
